 Muvo
Una plataforma para que cualquier museo tenga audioguías en más de 100 idiomas y acentos. El equipo del museo escribe los textos; la IA propone las traducciones, que una persona revisa, y las narra. El visitante escanea un QR junto a la obra y escucha en su idioma, sin instalar nada. Diseñada y construida en solitario, del reproductor a la infraestructura.
El problema
Durante décadas, una buena audioguía ha sido un privilegio de los grandes museos: aparatos que se prestan en taquilla, estudios de grabación, locutores y traductores para cada idioma. Un museo pequeño, un yacimiento o una exposición temporal no pueden permitírselo, y sus visitantes extranjeros se quedan con un cartel que no entienden.
Muvo parte de una idea sencilla: un museo pequeño de un pueblo de Galicia merece audioguías tan dignas como las del Louvre. El conocimiento sigue siendo del museo; lo único que cambia es lo que cuesta hacerlo llegar a cada visitante, en su idioma. Y no solo en un museo:
- Museos
- Exposiciones temporales
- Yacimientos arqueológicos
- Iglesias y patrimonio religioso
- Bodegas y fábricas visitables
- Parques naturales, zoos y jardines botánicos
- Festivales y fiestas populares
- Rutas urbanas y turísticas
El producto
- 01El museo escribeEl texto de cada pieza, en su idioma y con el rigor que exija la institución.
- 02La IA traduce, una persona revisaNingún idioma se publica sin que alguien del museo lo apruebe.
- 03La IA narraUna voz natural para cada idioma y acento. O la grabación propia del museo.
- 04El visitante escanea y escuchaUn QR por pieza. Sin aplicación, sin aparatos y sin registro.
El equipo del museo escribe el texto de cada pieza en su idioma, con el rigor que la institución exija. Muvo propone la traducción a los idiomas que se necesiten, una persona la revisa y la publica, y la IA la convierte en una narración con una voz natural para cada idioma y acento. Si el museo prefiere su propia grabación, la sube y sustituye a la voz generada.
Cada pieza tiene un único código QR, sea cual sea el idioma. El visitante lo escanea con su móvil, elige el idioma una sola vez y escucha. Sin aplicación que instalar, sin aparatos que devolver y sin registrarse. El reproductor lleva el logotipo y el color de cada museo, como en las dos audioguías de arriba.
Ahora mismo estoy rediseñando la web pública y el panel de gestión, sobre esta misma arquitectura.
Cómo está hecho
IA donde aporta, y solo ahí
La decisión de producto más importante fue dónde no usar IA. Muvo traduce y narra, pero nunca escribe. Todo lo que oye el visitante sale de un texto que el museo ha redactado y aprobado, así que no hay datos inventados sobre una obra.
- Traducción asistida, nunca automática. Claude propone cada traducción y esta pasa por su propio estado: borrador, revisada y publicada. Ningún idioma se publica sin que una persona lo haya aprobado.
- Roles con idiomas. Un museo puede tener administradores, editores, traductores y personas de solo lectura, y un traductor puede limitarse a los idiomas que le corresponden.
- La voz y el tono son del museo. Lo que tiene que ver con su identidad se configura, no lo decide un modelo.
Acento, no solo idioma
Una audioguía en Bogotá no puede sonar a Madrid. El modelo de voz, Gemini, solo acepta el idioma base: «es», no «es-CO». Así que el acento se dirige con notas de dirección, como se haría con un locutor: cada variante tiene en un catálogo propio su descripción de acento y sus notas de pronunciación, y se envían junto al texto.
- Un catálogo de idiomas vivo. Más de 100 idiomas y acentos, con sus notas de dirección y, si hace falta, un modelo distinto por variante, gestionados desde el panel interno sin tocar código.
- Un texto preparado para leerse en voz alta. Antes de narrar, el texto se limpia y se normalizan los párrafos para que las pausas caigan donde deben. El audio se entrega en MP3, listo para escucharse con poca cobertura.
- Cada escritura, su tipografía. El reproductor carga la familia adecuada para el árabe, el hebreo, el devanagari, el chino, el japonés, el coreano o el tailandés, además de una serif de lectura para los alfabetos latinos.
Guardar no es generar
Un museo edita sus textos muchas veces, y cada narración tiene un coste. Si cada cambio regenerase el audio, el coste de la IA se dispararía. El pipeline se diseñó para que solo se genere lo que de verdad se va a escuchar.
- GuardarGratis, tantas veces como haga falta
- PublicarEl único momento en que se genera audio
- ¿Ha cambiado el texto?Se compara el hash con el del audio actual
- Cada idioma, cuando está listo. La narración de una traducción se genera solo al publicar esa traducción, no por adelantado.
- Una cola de trabajos con límites. La generación va por una cola de eventos con reintentos, un máximo de trabajos simultáneos y de trabajos por minuto en cada museo, y una tarea de mantenimiento que recupera los que se quedan atascados. El panel muestra el estado de cada audio en directo.
Una API pensada para los picos
Cuando llega un autobús de turistas, cuarenta personas escanean el mismo QR a la vez. Por eso Muvo separa la API en tres planos con necesidades opuestas: la de gestión, privada y con permisos por rol; la de entrega, pública, de solo lectura y cacheada en la CDN; y la del equipo de Muvo, con su propia auditoría.
- La parte pública aguanta sola. Las respuestas se sirven desde la caché de la CDN sin tocar la base de datos, y el audio y las imágenes son ficheros inmutables identificados por su hash.
- Códigos que no se pueden adivinar. Los códigos de los QR son aleatorios y no secuenciales, para que nadie pueda recorrer el catálogo de un museo ni saber cuántas obras tiene.
- Cada museo, aislado. Todos los museos comparten base de datos, pero cada consulta se acota por museo con reglas de seguridad a nivel de fila en PostgreSQL, que se activan en cada transacción.
- Versionada desde el primer día, para que el reproductor web y una futura app nativa usen exactamente la misma API.
Pensado para quien escucha
- Recorridos que se recuerdan. Escanear el QR de un recorrido lleva a la primera parada. El listado de paradas, con lo ya escuchado marcado, se guarda en el propio móvil y se abre solo al terminar cada locución, con la siguiente parada pendiente a la vista.
- Varias formas de llegar a una obra: escanear su QR desde el propio reproductor, teclear su número de audioguía si el código falta o está dañado, o seguir el orden del recorrido.
- Sin datos personales. El idioma elegido se guarda en el dispositivo, nunca en el servidor.
- Accesible. La transcripción completa acompaña siempre al audio, el tamaño de la letra se puede ajustar y la pantalla no se apaga mientras suena la audioguía.
El potencial
- Guías independientes. El modelo de datos ya distingue entre instituciones y creadores individuales, para que un guía turístico pueda publicar su propio recorrido.
- Una app nativa sobre la misma API. El reproductor ya está preparado para funcionar dentro de una aplicación para iOS y Android reutilizando su código, sin una segunda versión de la interfaz.
- Datos para el museo. Qué piezas, salas e idiomas despiertan más interés, siempre de forma anónima, para decidir qué ampliar o traducir.
Stack: Next.js · TypeScript · Tailwind CSS · shadcn/ui · Neon (PostgreSQL con RLS) · Drizzle ORM · Inngest · Vercel Blob · Claude (traducción) · Gemini TTS · ffmpeg · Stripe · Capacitor.
Más proyectos
Otros productos que he ideado, construido y lanzado por mi cuenta.
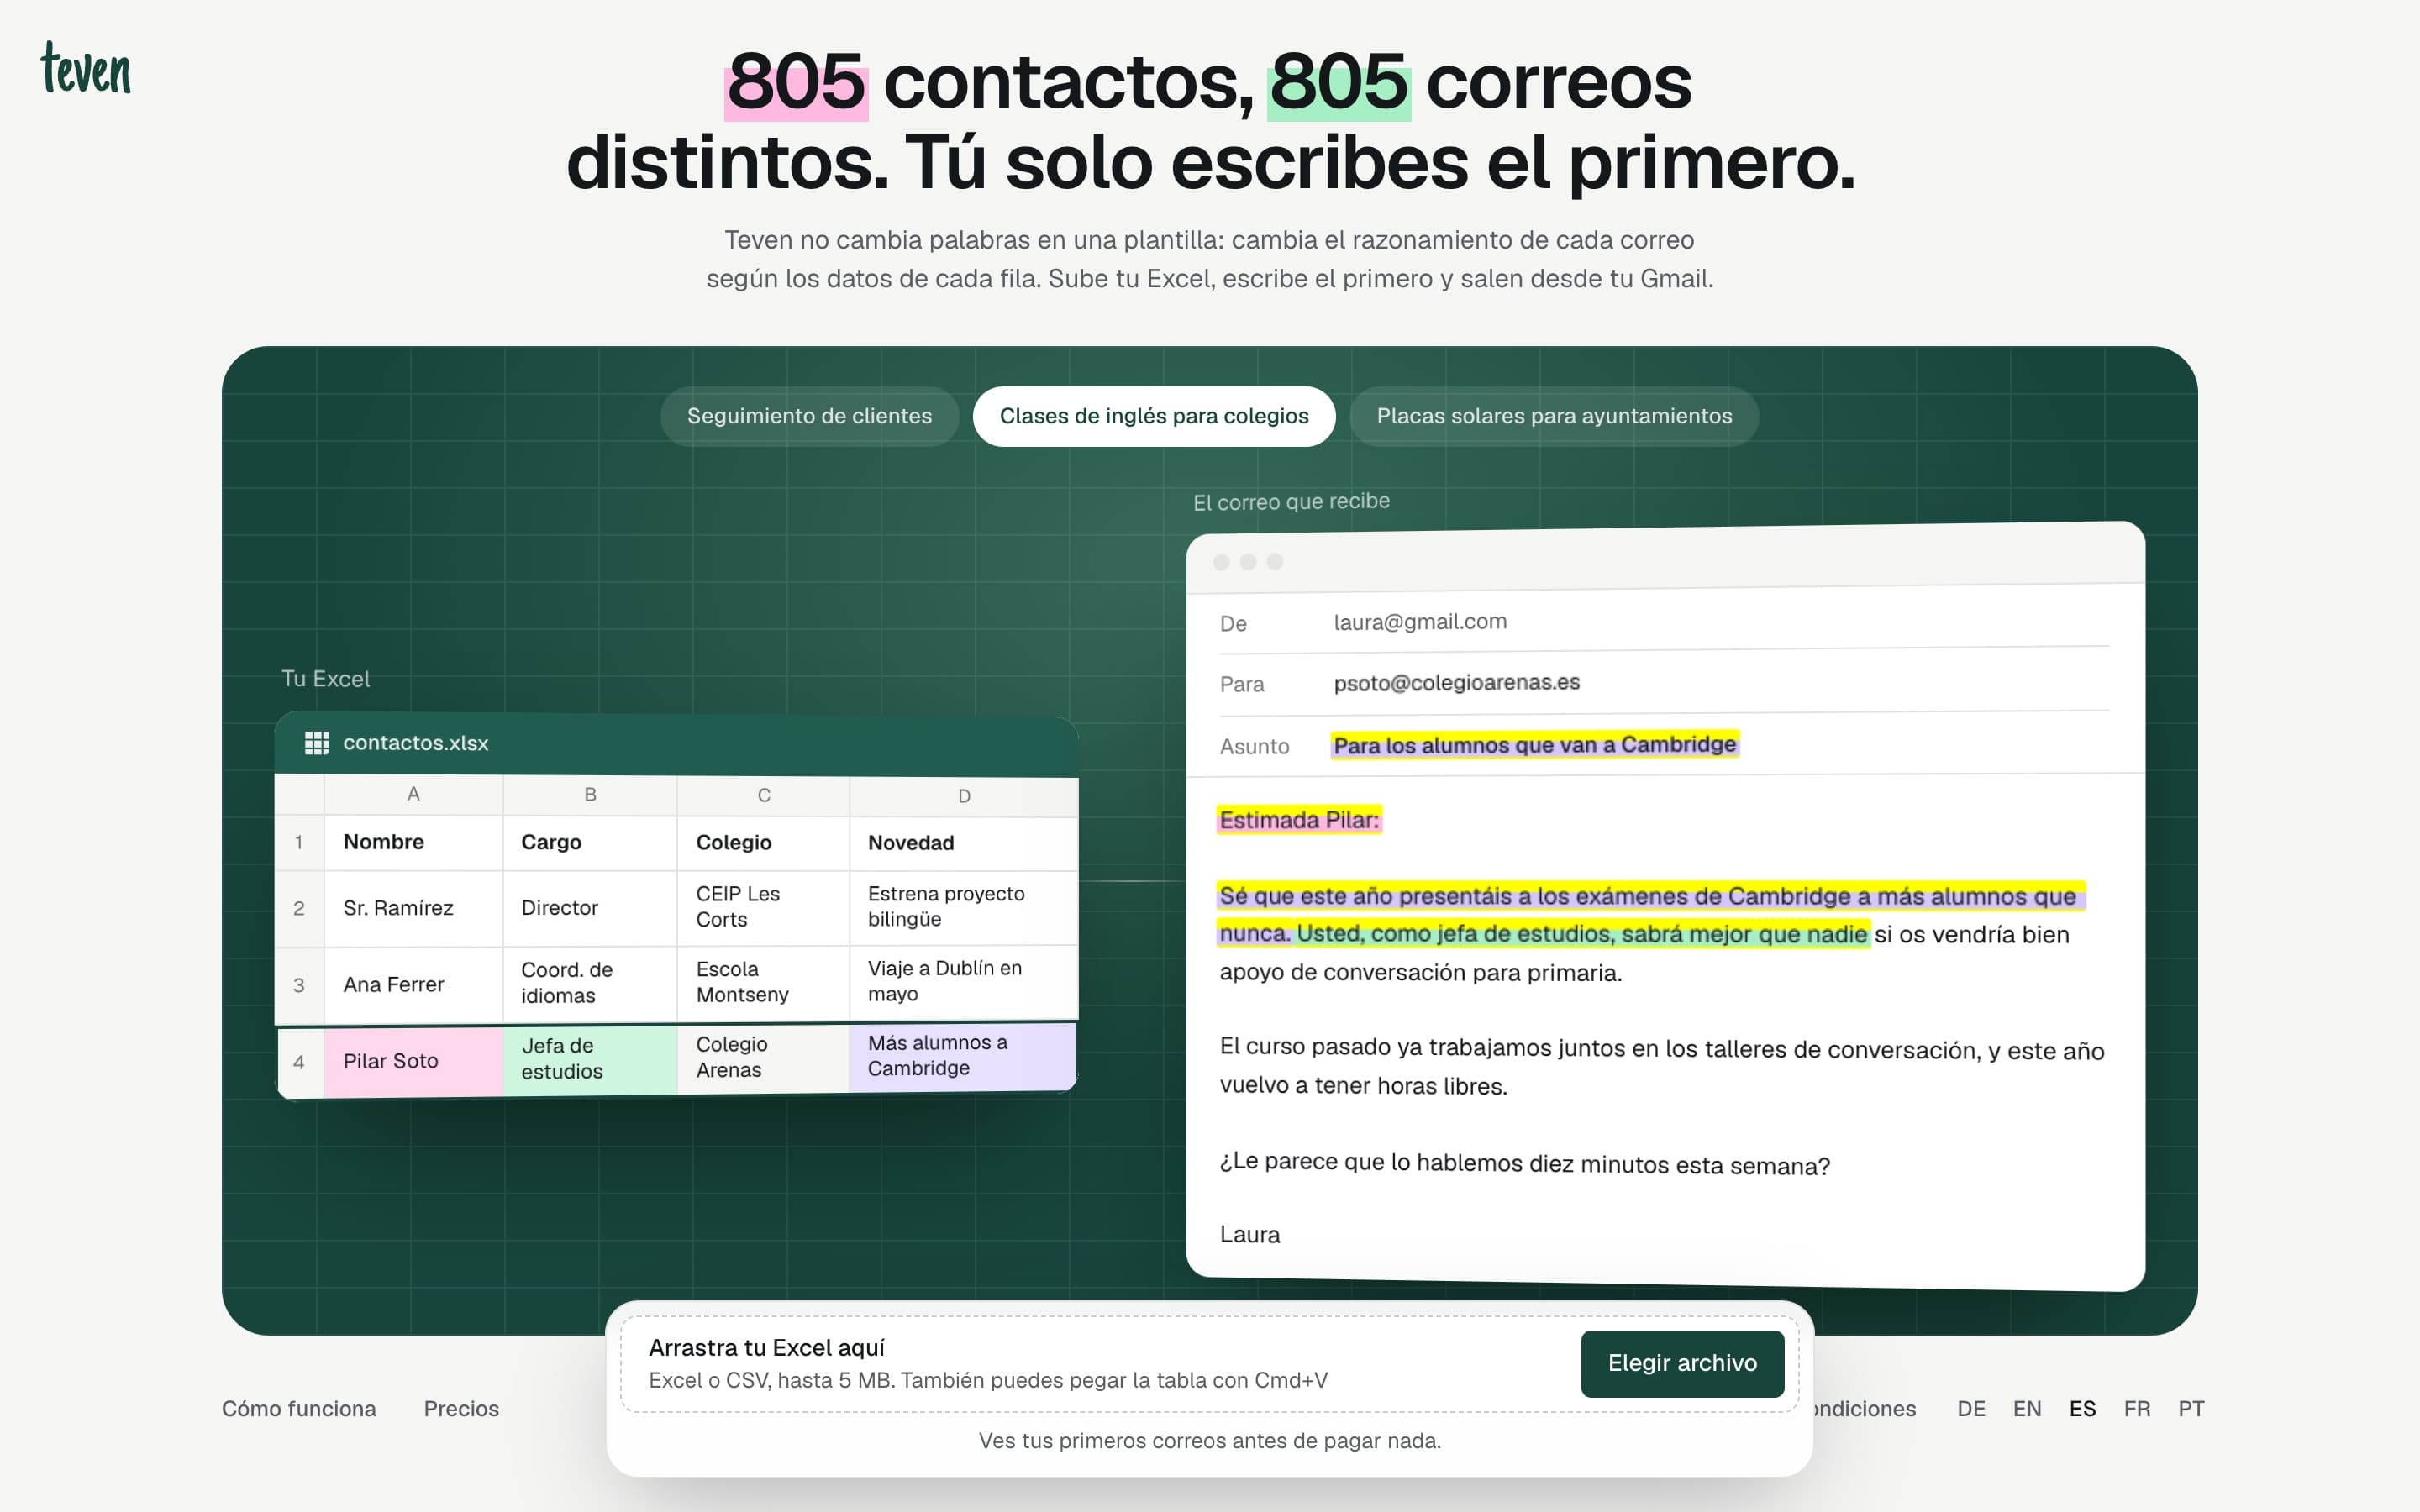
 TevenCorreos escritos uno a uno desde una hoja de cálculo, aprendidos de un solo ejemplo.Ver el proyecto →
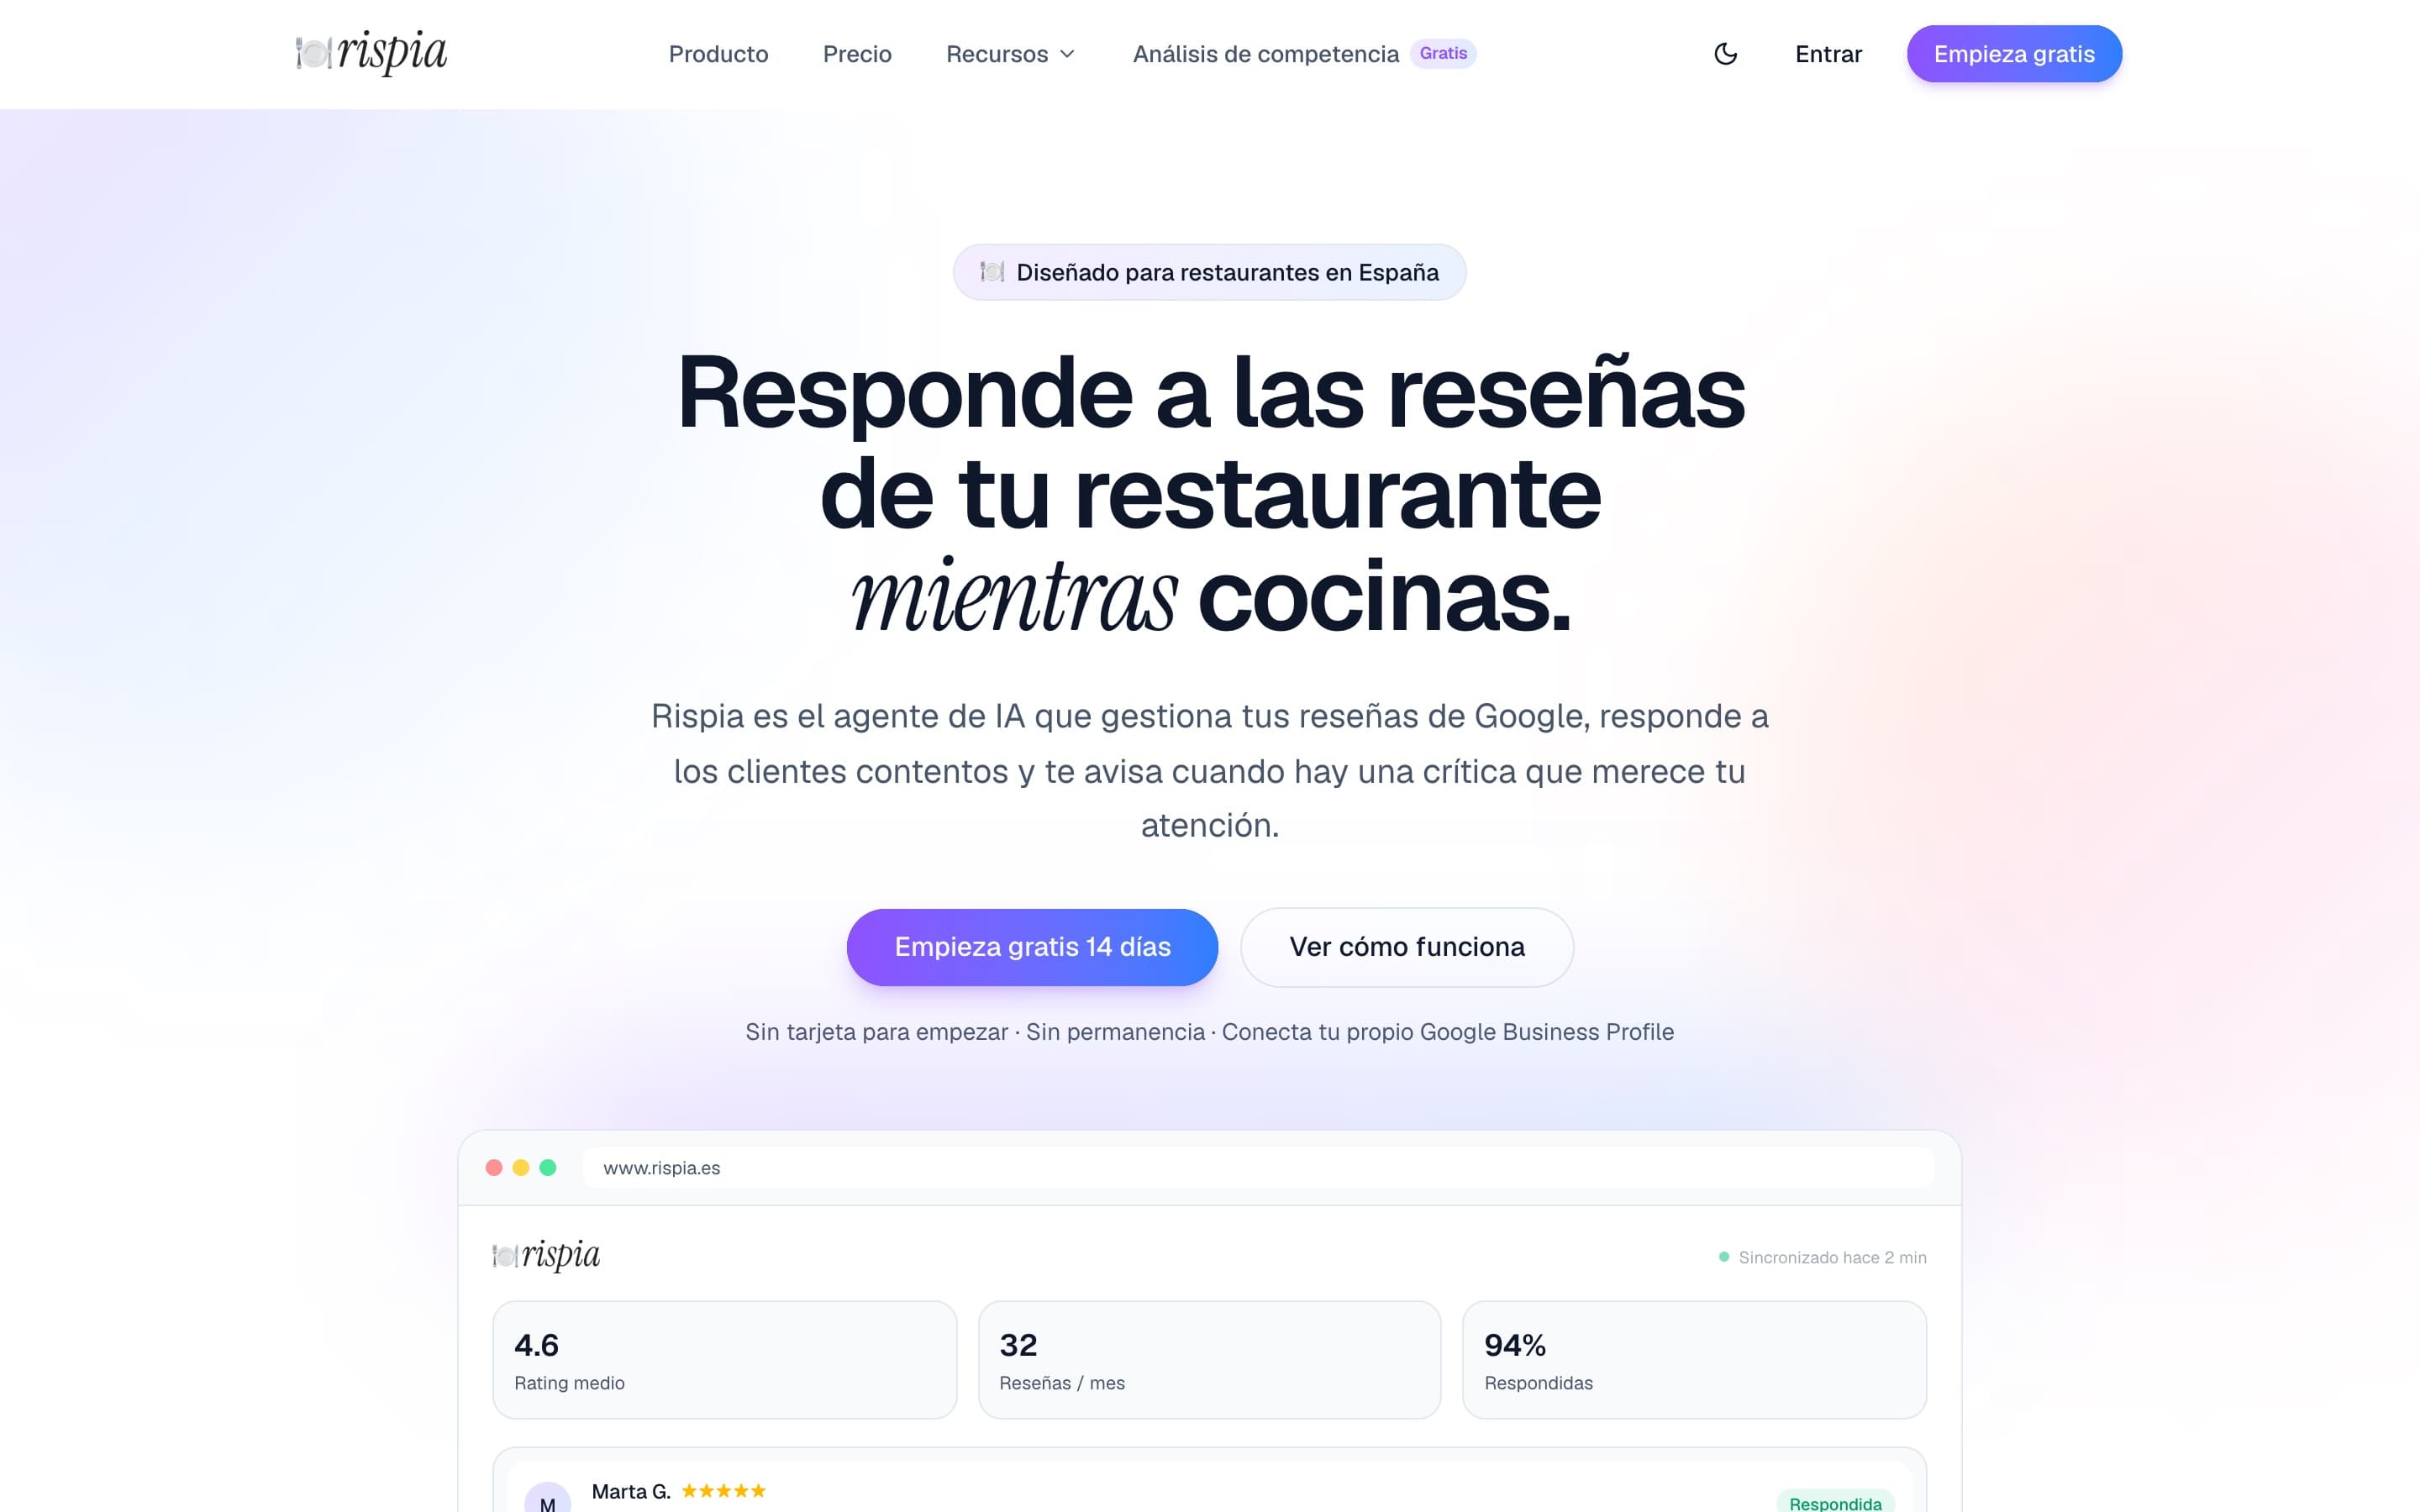
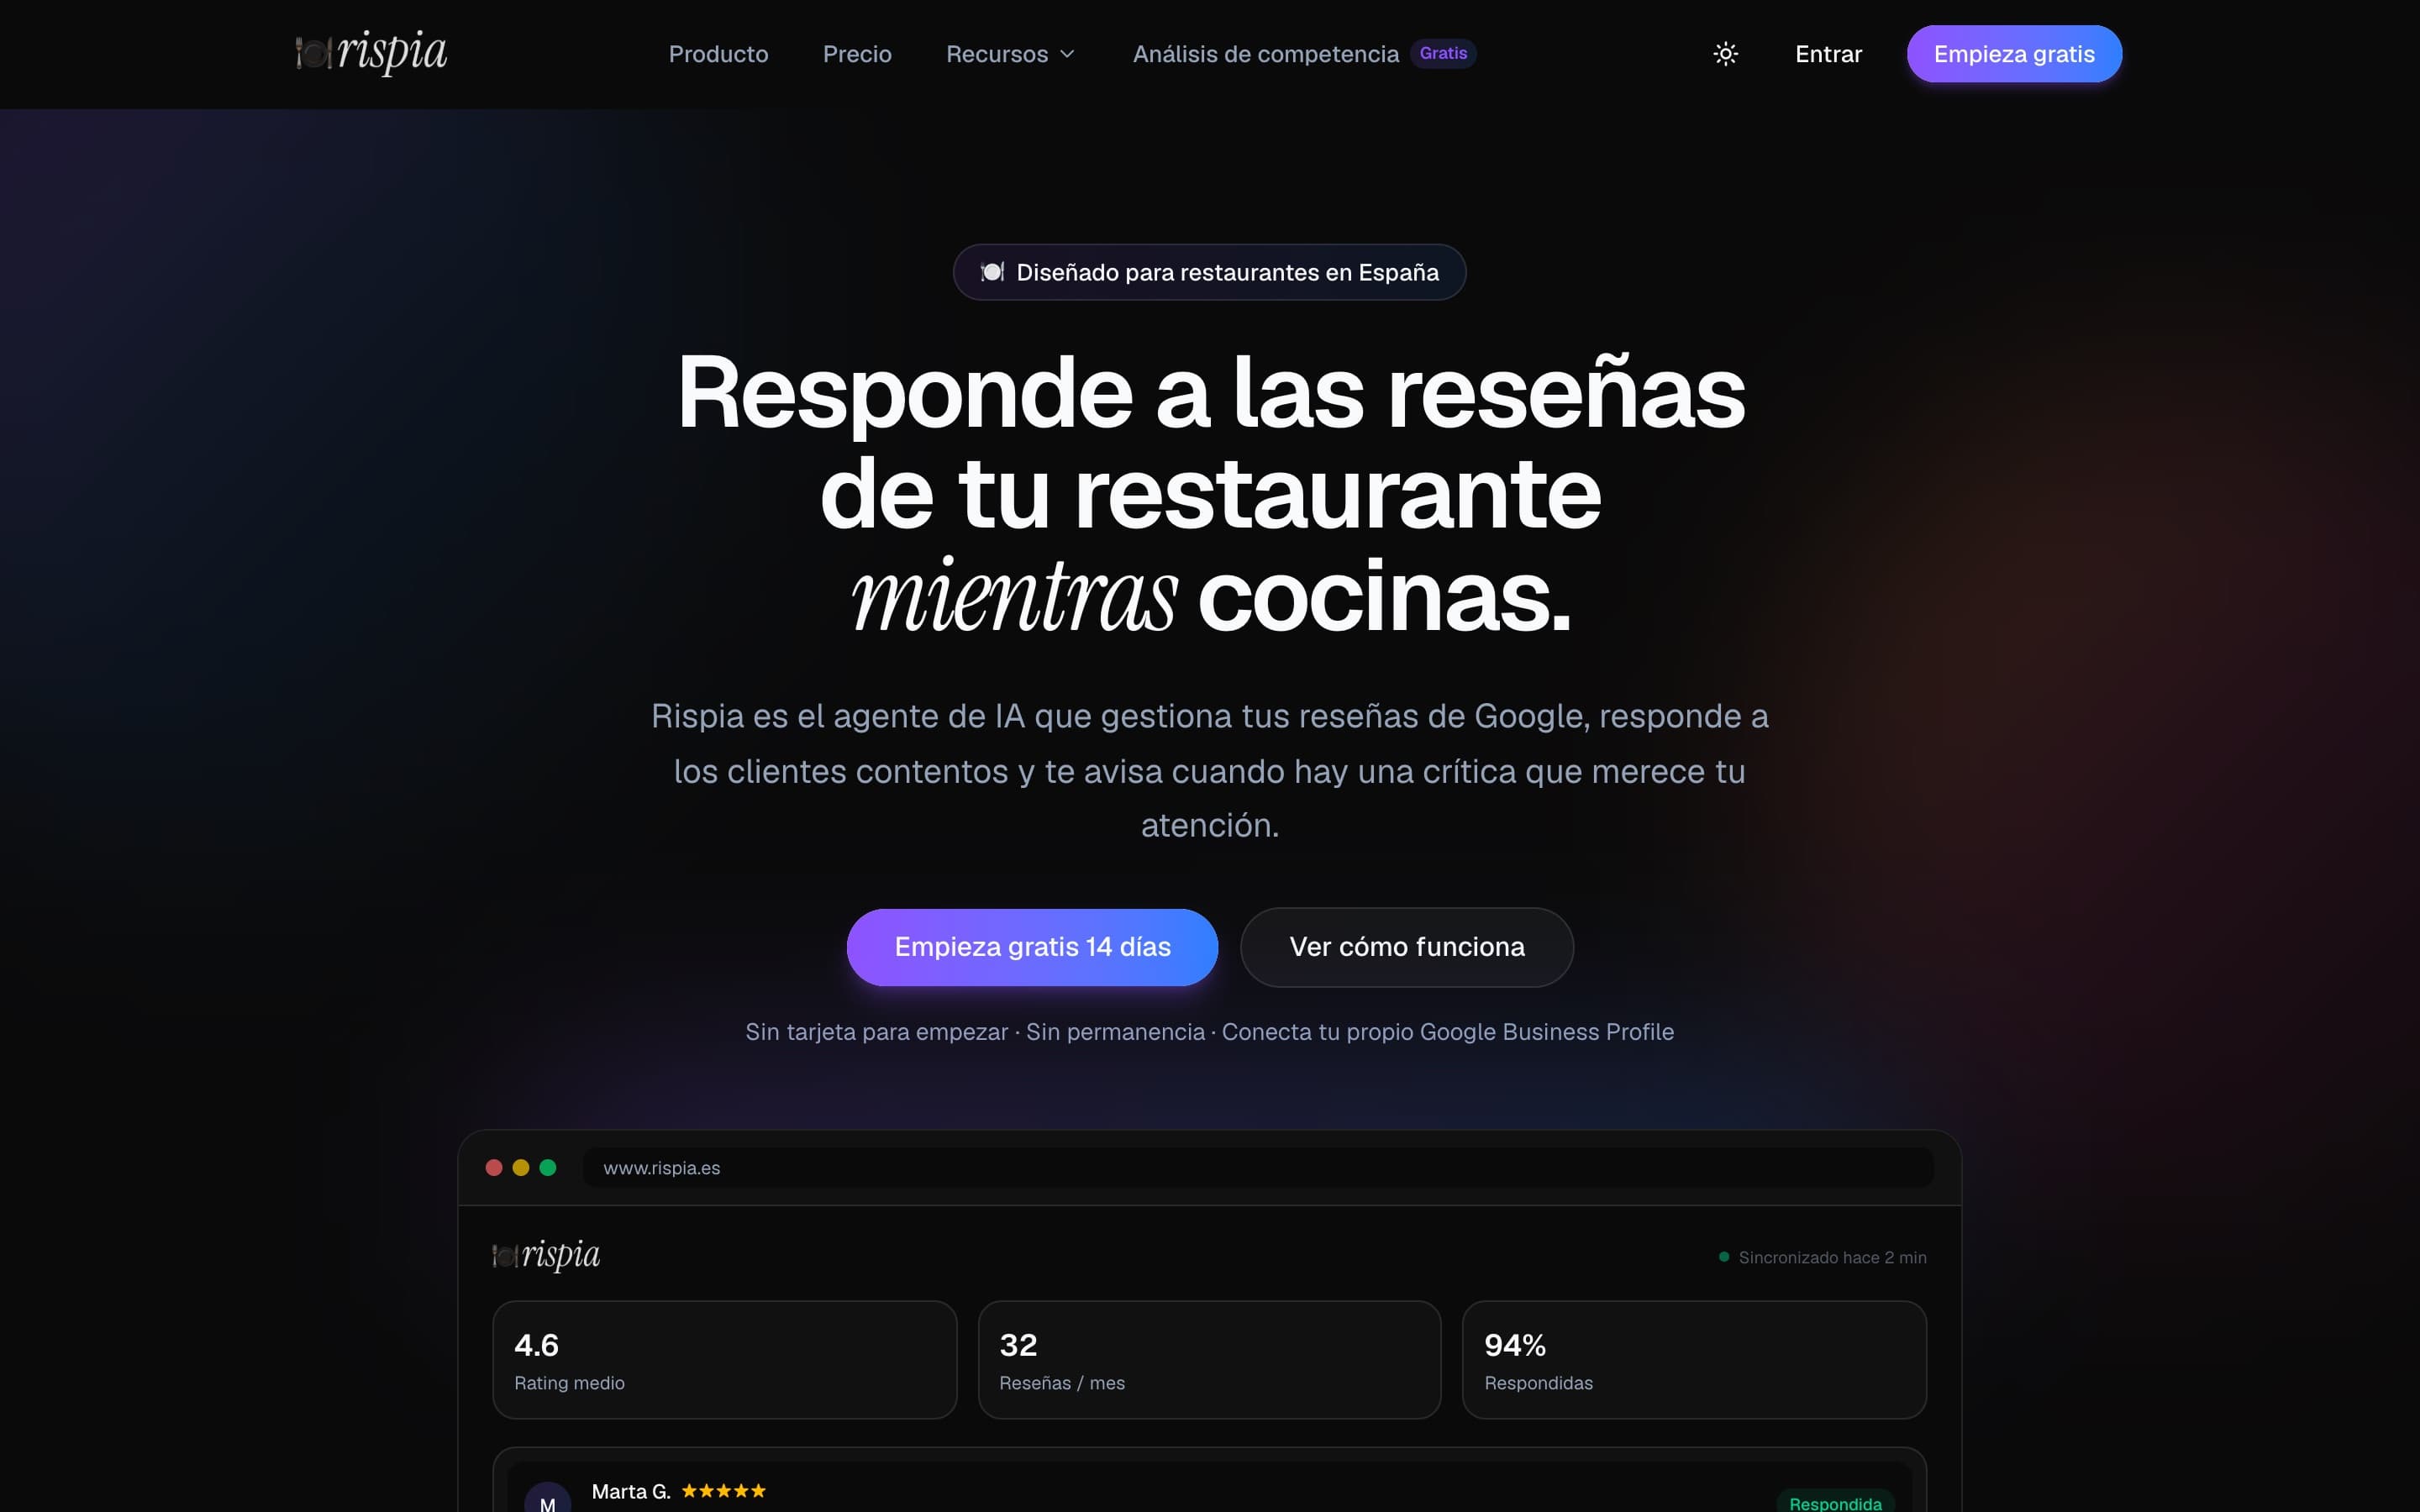
 RispiaUn agente que responde las reseñas de Google de un restaurante y avisa cuando hace falta una persona.Ver el proyecto →
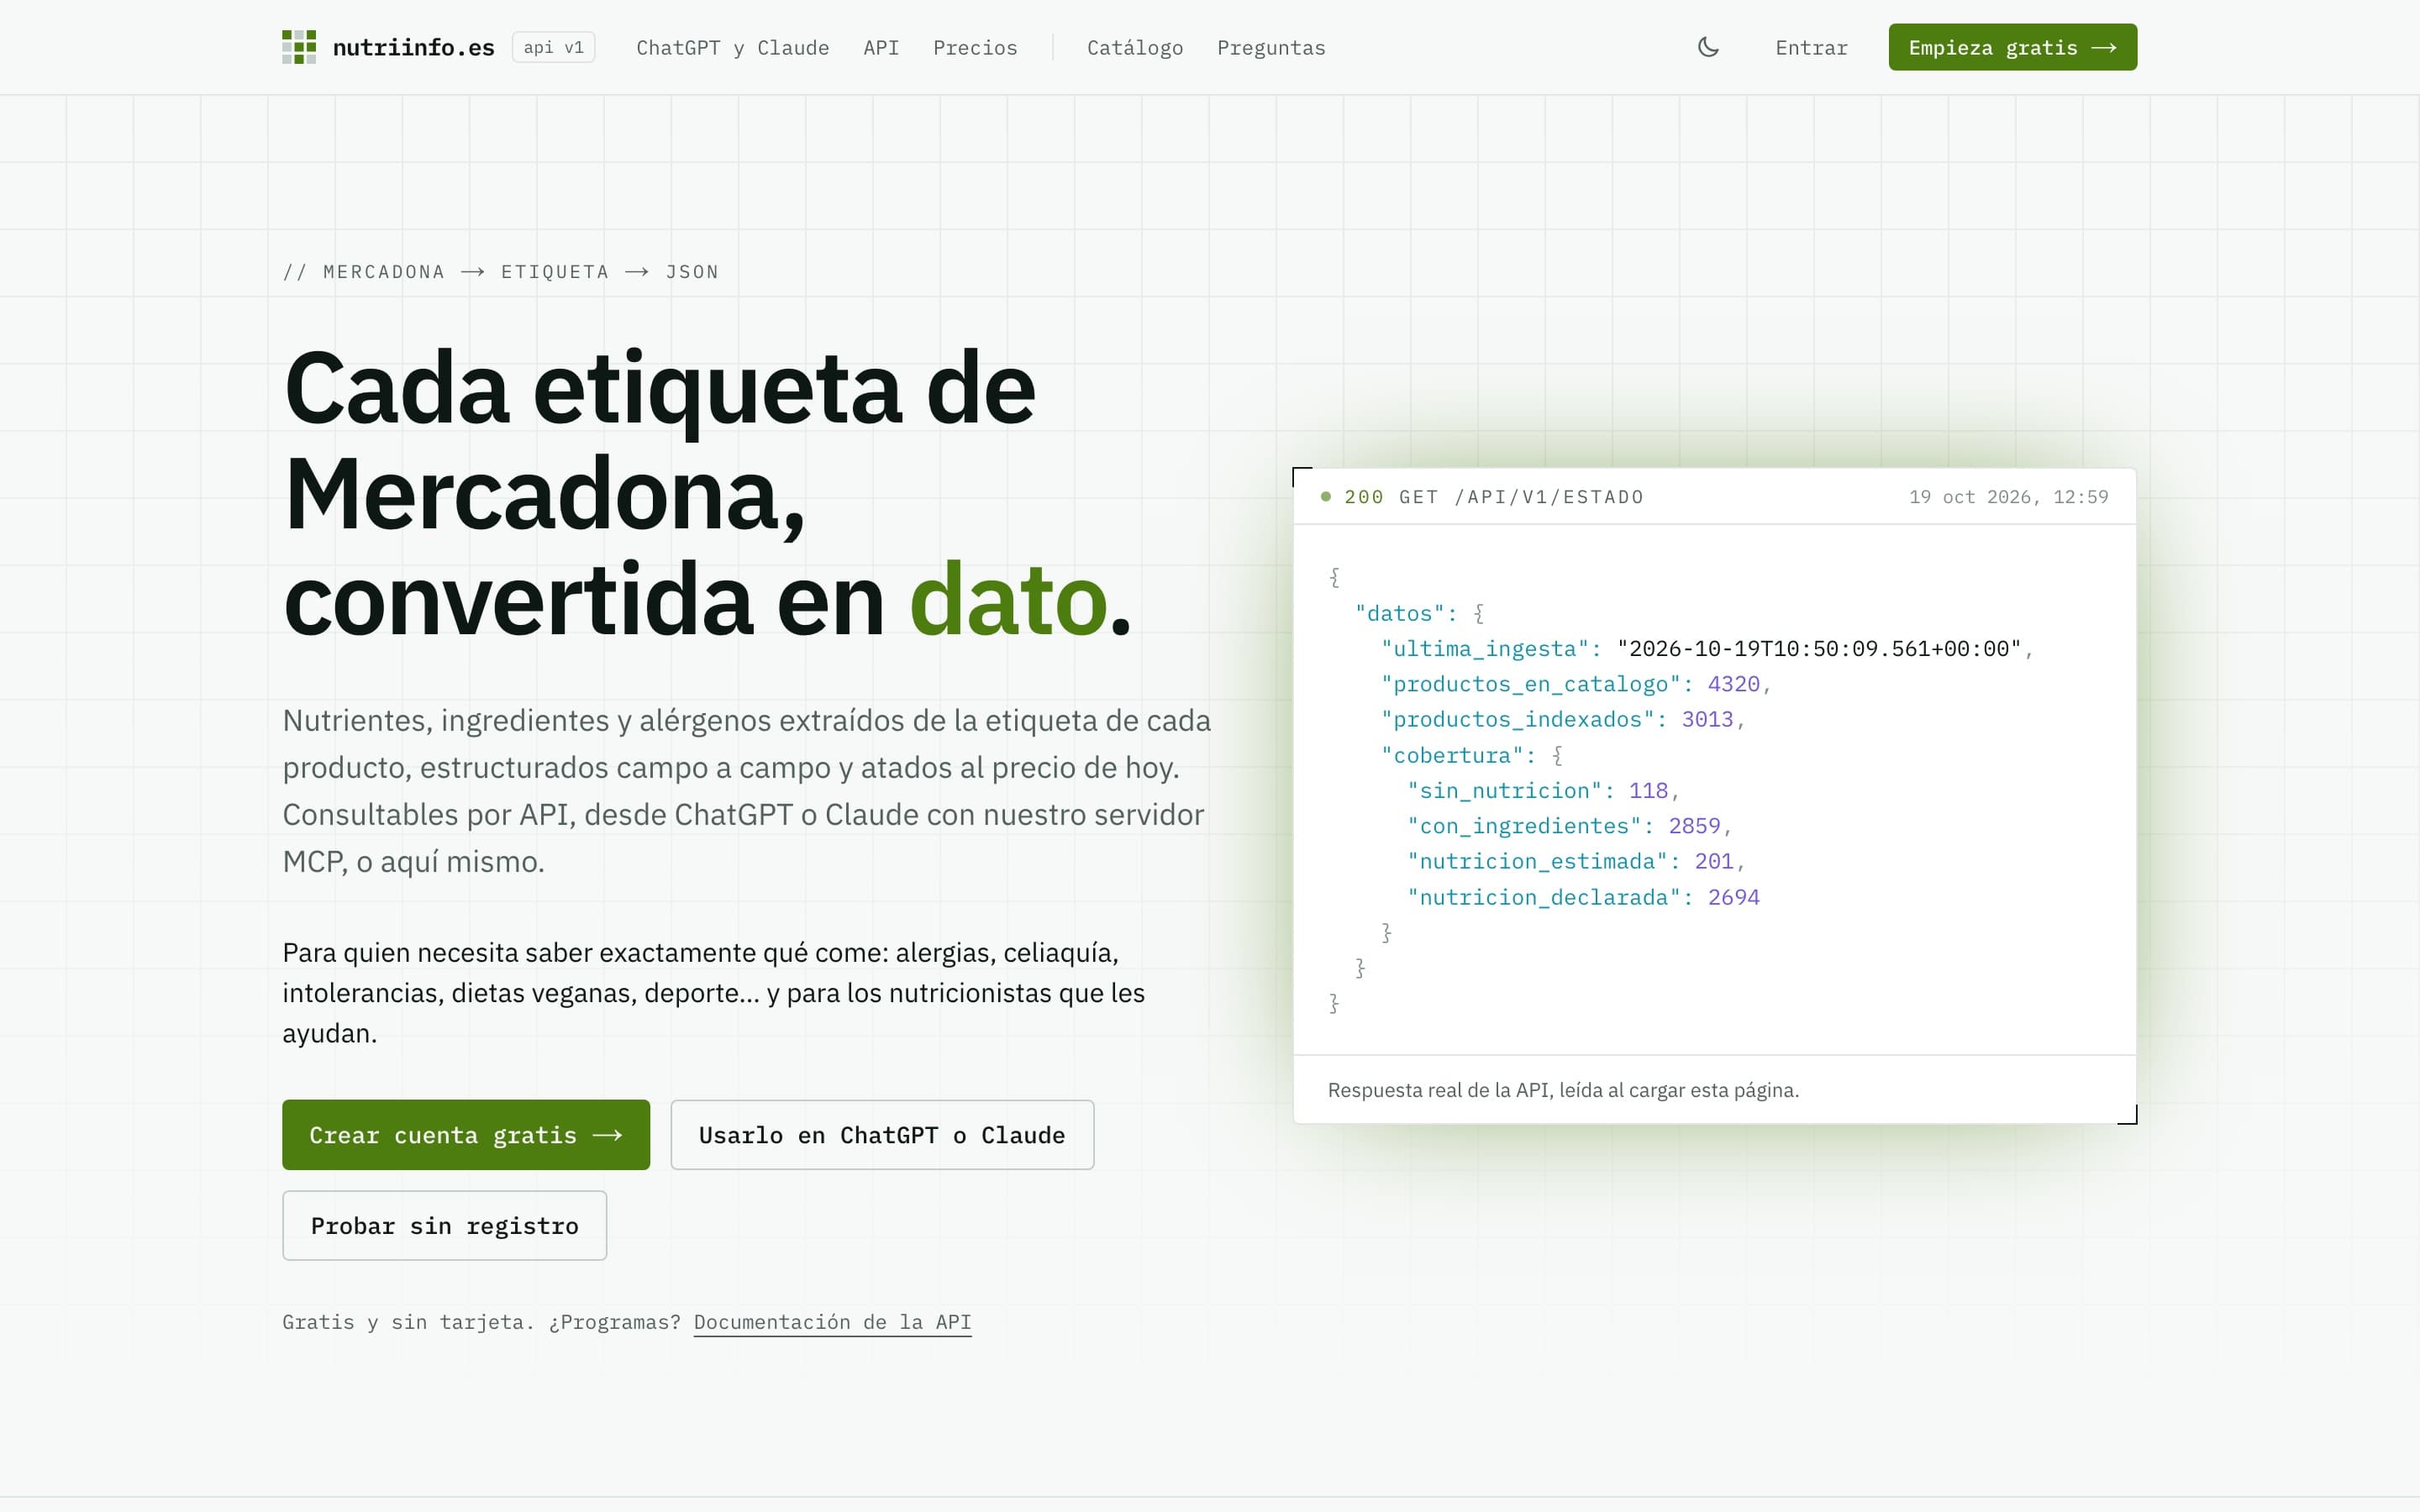
 Nutriinfo.esLas etiquetas de Mercadona convertidas en datos, por web, API y desde ChatGPT o Claude.Ver el proyecto →
Contacto
Escríbeme a hola@miquelgomis.es o en LinkedIn. El código está en GitHub.